
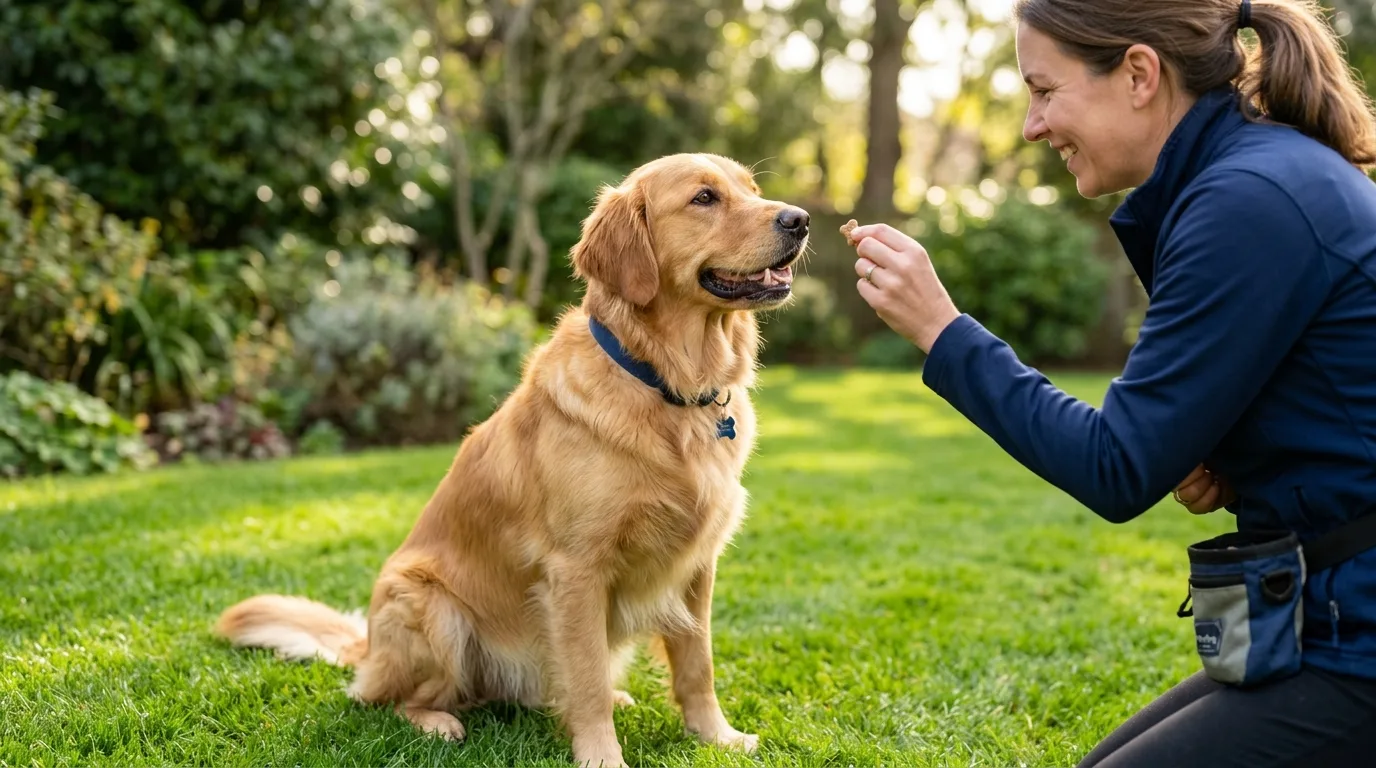
วิทยาศาสตร์เบื้องหลังการเรียนรู้ของสุนัข: ก้าวข้ามแนวคิดจ่าฝูงสู่การเสริมแรงเชิงบวก
ในอดีต วงการฝึกสุนัขมักได้รับอิทธิพลจากความเชื่อเรื่อง "ทฤษฎีจ่าฝูง" (Dominance Theory หรือ Alpha Dog Concept) ซึ่งเชื่อว่าเจ้าของต้องแสดงตนเป็นผู้มีอำนาจเหนือกว่าผ่านการลงโทษ การกระตุกสายจูงอย่างแรง หรือการจับสุนัขกดนอนหงายท้อง (Alpha Roll) ทว่าตลอดสองทศวรรษที่ผ่านมา วงการสัตวแพทย์และวิทยาศาสตร์พฤติกรรมสัตว์สากลได้พิสูจน์แล้วว่า ทฤษฎีดังกล่าวมีพื้นฐานมาจากการศึกษาพฤติกรรมหมาป่าในกรงขังที่ไม่เป็นธรรมชาติ และไม่สามารถนำมาปรับใช้กับสุนัขบ้าน (Canis lupus familiaris) ได้อย่างถูกต้อง
ตามแถลงการณ์อย่างเป็นทางการของ American Veterinary Society of Animal Behavior (AVSAB) ระบุอย่างชัดเจนว่า การฝึกสุนัขด้วยการสร้างความกลัว ความเจ็บปวด หรืออุปกรณ์ที่ส่งผลเชิงลบ (Aversive Methods เช่น ปลอกคอกระตุกแบบหนาม หรือปลอกคอไฟฟ้า) ไม่เพียงแต่ไม่ได้ผลดีกว่าในระยะยาว แต่ยังเพิ่มความเสี่ยงอย่างมีนัยสำคัญต่อปัญหาสุขภาพจิต ความเครียดเรื้อรัง และอาจกระตุ้นให้สุนัขแสดงพฤติกรรมก้าวร้าวเพื่อป้องกันตนเองได้ในที่สุด
ในทางตรงกันข้าม งานวิจัยทางวิทยาศาสตร์ที่ตีพิมพ์ในวารสาร PLOS ONE โดย ดร. Ana Catarina Vieira de Castro และคณะ (2020) ได้ศึกษาเปรียบเทียบสุนัขเลี้ยงที่ผ่านการฝึกด้วยวิธีต่างกัน และพบว่า สุนัขที่ได้รับการฝึกด้วย แรงเสริมเชิงบวก (Positive Reinforcement Training) มีระดับฮอร์โมนความเครียดคอร์ติซอล (Cortisol) ต่ำกว่าอย่างเห็นได้ชัด มีความกระตือรือร้นในการแก้ปัญหา และมีความผูกพันที่มั่นคง (Secure Attachment) กับผู้เลี้ยงมากกว่าอย่างมีนัยสำคัญทางสถิติ
เข้าใจกลไก Operant Conditioning: สุนัขเรียนรู้จากผลลัพธ์ของการกระทำ
หัวใจสำคัญของแรงเสริมเชิงบวกมีรากฐานมาจากทฤษฎีการวางเงื่อนไขผลกรรม (Operant Conditioning) ซึ่งค้นพบโดยนักจิตวิทยา บี.เอฟ. สกินเนอร์ (B.F. Skinner) โดยมีหลักการพื้นฐานที่เรียบง่ายแต่ทรงพลังคือ "พฤติกรรมใดที่ทำแล้วได้รับผลลัพธ์ที่ดี พฤติกรรมนั้นจะมีแนวโน้มเกิดขึ้นซ้ำอีก"
ในมุมมองของสุนัข พวกเขาไม่ได้มองโลกผ่านมิติของ "ความถูก-ผิดทางศีลธรรม" แต่มองผ่านมิติของ "ทำแล้วปลอดภัย ได้ประโยชน์ หรือทำแล้วเสียประโยชน์" การฝึกแบบ Positive Reinforcement (มักเรียกย่อว่า +R) จึงเน้นการมอบสิ่งตอบแทนที่สุนัขพึงพอใจอย่างยิ่งเมื่อสุนัขแสดงพฤติกรรมที่เราต้องการ เช่น การนั่งลง การสบตา หรือการเดินเคียงข้างเจ้าของ แทนที่จะรอให้สุนัขทำผิดแล้วจึงลงโทษ
3 องค์ประกอบหลักในการฝึก: ตัวทำเครื่องหมาย จังหวะเวลา และมูลค่ารางวัล
การฝึกด้วยแรงเสริมเชิงบวกจะได้ผลรวดเร็วและแม่นยำ เจ้าของจำเป็นต้องเข้าใจและฝึกฝน 3 องค์ประกอบสำคัญดังต่อไปนี้ให้ชำนาญ:
1. ตัวทำเครื่องหมายพฤติกรรม (Event Marker / Bridging Stimulus)
เนื่องจากมนุษย์ไม่สามารถยื่นขนมเข้าปากสุนัขได้ทันทีในเสี้ยววินาทีที่สุนัขกำลังแสดงพฤติกรรม เราจึงต้องมี "สะพานเชื่อมสัญญาณ" (Bridging Stimulus) ที่ช่วยบอกสุนัขอย่างแม่นยำว่า การกระทำใดคือจุดที่ทำให้เขาได้รับรางวัล
- คลิกเกอร์ (Clicker): อุปกรณ์กล่องพลาสติกขนาดเล็กที่ให้เสียง "คลิก" สั้น คม ชัดเจน และมีโทนเสียงคงที่เสมอ เหมาะอย่างยิ่งสำหรับลูกสุนัขและงานฝึกที่ต้องการความแม่นยำสูง
- เสียงพูดทำเครื่องหมาย (Verbal Marker): หากไม่มีคลิกเกอร์ สามารถใช้คำสั้นๆ โทนเสียงกระตือรือร้น เช่น คำว่า "Yes!" หรือ "ดี!" โดยต้องออกเสียงด้วยโทนเดิมเสมอ
2. จังหวะเวลาที่แม่นยำ (Timing)
สมองของสุนัขเชื่อมโยงพฤติกรรมเข้ากับผลลัพธ์ภายในกรอบเวลาสั้นมาก (เฉลี่ยไม่เกิน 1-2 วินาที) หากคุณต้องการสอนคำสั่ง "นั่ง" คุณจะต้องกดคลิกเกอร์หรือเปล่งเสียง "Yes!" ทันทีที่ก้นของสุนัขแตะพื้นสนิท หากคุณมาร์กช้าไปแม้เพียงเสี้ยววินาทีตอนที่สุนัขกำลังจะลุกขึ้น สุนัขจะเข้าใจผิดว่าการลุกขึ้นคือสิ่งที่ได้รับรางวัล
3. ลำดับขั้นของรางวัล (Reward Hierarchy)
สิ่งตอบแทนไม่ได้มีค่าเท่ากันเสมอไปในสายตาของสุนัข ผู้ฝึกควรแบ่งรางวัลออกเป็นระดับตามความน่าสนใจและระดับสิ่งเร้าแวดล้อม:
- รางวัลมูลค่าต่ำ (Low-Value): เช่น อาหารเม็ดประจำวัน เหมาะสำหรับใช้ฝึกทบทวนในบ้านที่เงียบสงบและไม่มีสิ่งรบกวน
- รางวัลมูลค่าปานกลาง (Medium-Value): เช่น ขนมขบเคี้ยวสำหรับสุนัขกลิ่นหอม หรือบิสกิตชิ้นเล็ก
- รางวัลมูลค่าสูง (High-Value): เช่น อกไก่ต้มฉีก ตับต้มสุก หรือเนื้อปลาแซลมอนอบแห้ง เหมาะสำหรับใช้เมื่อต้องฝึกคำสั่งใหม่ คำสั่งที่มีความยาก หรือเมื่อพาสุนัขออกไปฝึกนอกบ้านที่มีสิ่งกระตุ้นสูง
ขั้นตอนปฏิบัติ: 3 สเต็ปฝึกคำสั่งพื้นฐานด้วยเทคนิค Lure-Reward
วิธีที่ง่ายและได้ผลดีที่สุดสำหรับเจ้าของมือใหม่ในการสอนท่าทาง เช่น "นั่ง" (Sit) หรือ "หมอบ" (Down) คือเทคนิคการล่อด้วยอาหาร (Luring) ตามขั้นตอนดังนี้:
ขั้นตอนที่ 1: การล่อและกำหนดทิศทาง (Luring)
ถือขนมชิ้นเล็กไว้ระหว่างนิ้วหัวแม่มือกับนิ้วชี้ นำขนมไปจ่อใกล้ปลายจมูกของสุนัขในระยะประมาณ 1-2 เซนติเมตรเพื่อให้ได้กลิ่นชัดเจน จากนั้นค่อยๆ เคลื่อนมือขึ้นด้านบนและเฉียงไปข้างหลังข้ามกระหม่อมของสุนัขอย่างช้าๆ เมื่อศีรษะของสุนัขเงยตามกลิ่นขนม จุดศูนย์ถ่วงของร่างกายจะเลื่อนไปด้านหลัง ทำให้ส่วนสะโพกและก้นแตะลงบนพื้นอย่างเป็นธรรมชาติ
ขั้นตอนที่ 2: ทำเครื่องหมายทันที (Marking)
ในวินาทีที่ก้นของสุนัขสัมผัสพื้นอย่างสมบูรณ์ ให้กดคลิกเกอร์หนึ่งครั้งหรือเปล่งเสียง "Yes!" ทันทีอย่างชัดเจน
ขั้นตอนที่ 3: ส่งมอบรางวัล (Rewarding)
คลายนิ้วและป้อนขนมให้สุนัขกินทันทีภายใน 1-2 วินาทีหลังการมาร์ก พร้อมรอยยิ้มและคำชมอย่างอ่อนโยน
ขั้นตอนต่อยอด: การลดตัวช่วย (Fading the Lure) และใส่คำสั่งเสียง
หลังจากสุนัขทำตามท่าทางได้อย่างคล่องแคล่ว 5-10 ครั้ง ให้เริ่มซ่อนขนมไว้ในกระเป๋า แล้วทำท่าทางมือเปล่าแบบเดิม (กลายเป็น Hand Signal) เมื่อสุนัขทำตามท่าทางมือได้ถูกต้อง จึงค่อยเริ่มใส่คำสั่งเสียง เช่น พูดคำว่า "นั่ง" ล่วงหน้า 1 วินาทีก่อนทำสัญญาณมือ เพื่อให้สุนัขเชื่อมโยงเสียงคำสั่งเข้ากับพฤติกรรม
แนวทางปรับพฤติกรรมไม่พึงประสงค์: หลักการ LIMA และวิธีหาพฤติกรรมทดแทน
ตามแนวทางสากลของ Association of Professional Dog Trainers (APDT) มีการกำหนดกรอบจริยธรรมที่เรียกว่า LIMA (Least Intrusive, Minimally Aversive) ซึ่งเน้นย้ำว่าเมื่อสุนัขมีพฤติกรรมที่ไม่พึงประสงค์ ผู้เลี้ยงควรจัดการด้วยการปรับสภาพแวดล้อมและสอนพฤติกรรมทดแทน มากกว่าการลงโทษ
เทคนิคสอนพฤติกรรมทางเลือก (Differential Reinforcement of Alternative Behavior - DRA)
ปัญหาพฤติกรรมยอดนิยม เช่น สุนัขชอบกระโดดใส่แขกที่มาเยี่ยมบ้าน หรือเห่าเรียกร้องอาหารที่โต๊ะ เจ้าของมักใช้วิธีดุ ผลัก หรือตะโกน ซึ่งสุนัขอาจตีความว่าการดุคือ "การได้รับความสนใจ" จากเจ้าของ
แนวทางแก้ไขที่ถูกต้องตามหลักวิทยาศาสตร์คือ การหา "พฤติกรรมทางเลือกที่ทำพร้อมกันไม่ได้" (Incompatible Behavior):
- กรณีสุนัขชอบกระโดดใส่: สุนัขไม่สามารถกระโดดสองขาพร้อมกับนั่งสี่ขาลงกับพื้นได้ในเวลาเดียวกัน ดังนั้น ให้ฝึกสุนัขว่า "เมื่อมีคนเดินเข้าประตูบ้าน สุนัขจะต้องนั่งลงกับพื้นเท่านั้นจึงจะได้รับคำทักทายและขนม"
- กรณีสุนัขเห่าเรียกร้อง: ให้เพิกเฉยโดยสมบูรณ์ (ห้ามสบตา ห้ามพูด ห้ามสัมผัสตัว) เมื่อสุนัขเงียบและยอมนอนลงอย่างสงบอย่างน้อย 3-5 วินาที จึงค่อยมอบขนมและคำชมเพื่อเสริมแรงความสงบ (Reinforcing Calmness)
ข้อควรระวังและเทคนิคเสริมเพื่อความสำเร็จระยะยาว
- ฝึกเป็นช่วงสั้นๆ แต่สม่ำเสมอ (Micro-Sessions): สมาธิของสุนัขเทียบได้กับเด็กเล็ก การฝึกวันละ 5-10 นาที วันละ 2-3 รอบ มีประสิทธิภาพมากกว่าการฝึกรวดเดียว 1 ชั่วโมง ซึ่งจะทำให้สุนัขเหนื่อยล้าและหมดความสนใจ
- อย่าสั่งคำสั่งซ้ำๆ (Do Not Repeat Cues): หากสั่ง "นั่ง" แล้วสุนัขยังไม่ทำ ห้ามสั่ง "นั่งๆๆๆ" ซ้ำหลายรอบ เพราะจะทำให้คำสั่งกลายเป็นเสียงรบกวนที่สุนัขเรียนรู้ที่จะเพิกเฉย ให้หยุดรอประเมินประมาณ 3 วินาที หากสุนัขไม่ทำ แสดงว่าสิ่งเร้าแวดล้อมอาจสูงเกินไป หรือยังไม่เข้าใจคำสั่งดีพอ ให้ถอยกลับไปหนึ่งสเต็ป
- กฎ 3Ds (Distance, Duration, Distraction): เมื่อสุนัขเริ่มทำคำสั่งได้ ให้ค่อยๆ เพิ่มระดับความยากทีละอย่าง เช่น เพิ่มระยะห่างระหว่างตัวคุณกับสุนัข (Distance), เพิ่มระยะเวลาที่ให้นิ่งรอ (Duration), หรือเพิ่มสิ่งรบกวนรอบตัว (Distraction) อย่าเพิ่มทั้งสามสิ่งพร้อมกันในครั้งเดียว
บทสรุป: สร้างสายสัมพันธ์ที่แน่นแฟ้นด้วยความเข้าใจและเคารพซึ่งกันและกัน
การฝึกสุนัขด้วยแรงเสริมเชิงบวก ไม่ใช่เพียงแค่เทคนิคในการออกคำสั่งให้สุนัขทำตามใจมนุษย์ แต่คือการสร้างช่องทางการสื่อสารสองทางที่เปี่ยมด้วยความเข้าใจ ความปลอดภัย และความไว้วางใจ เมื่อสุนัขรู้ว่าการทำงานร่วมกับเจ้าของนำมาซึ่งความสุขและรางวัล พวกเขาจะมีความกระตือรือร้นในการเรียนรู้ เติบโตเป็นสุนัขที่มีสุขภาพจิตมั่นคง และเป็นสมาชิกที่น่ารักของครอบครัวอย่างแท้จริง
แหล่งข้อมูลอ้างอิงและการค้นคว้า
- American Veterinary Society of Animal Behavior (AVSAB) (2021). Position Statement on Humane Dog Training. https://avsab.org/resources/position-statements/
- Vieira de Castro, A. C., Fuchs, D., Morello, G. M., Pastur, S., de Sousa, L., & Olsson, I. A. S. (2020). Does training method matter? Evidence for the negative impact of aversive-based methods on companion dog welfare. PLOS ONE, 15(12), e0225023. DOI: 10.1371/journal.pone.0225023
- World Small Animal Veterinary Association (WSAVA) (2024). Global Animal Welfare Guidelines: Behavioral Health and Positive Handling. https://wsava.org/global-guidelines/animal-welfare-guidelines/
- Association of Professional Dog Trainers (APDT) (2024). The Science Behind Positive Reinforcement Training and the LIMA Framework. https://apdt.com/